Max Hernandez

Laberinto - Ejemplo de Canvas en HTML5

jueves, 10 de mayo de 2012

Tecnología RFID para dispositivos moviles

 [Imagen obtenida de:http://www.viko-eas.com/Uploadfiles/UploadFile/RFID-Chip.jpg]


¿Qué es RFID?
La identificación por radio frecuencia(Radio Frequency  Identification) es una tecnología para distribución.
Esta tecnología funciona con tres componentes básicos los cuales son:

    Una etiqueta electrónica
    Un lector de la etiqueta electrónica
    Una base de datos

El lector electrónico envía una señal de radiofrecuencia a una distancia promedio de 300 metros, esto provoca que la etiqueta electrónica con una micro antena recibe la onda y responde con un código de identificación único. Después este código puede ser utilizado para acceder una base de datos y obtener toda la información relacionada con esta etiqueta.


Ventajas:

  • El principal competidor con esta tecnología es el código de barras y a diferencia de esa el RFID no necesita contacto visual con la etiqueta para funcionar.
  • El id de las etiquetas puede ser modificado estando ya en uso.
  • Es mas complicado copiar una etiqueta RFID que un código de barras.
  • El RFID puede contener mayor información en menos espacio que el código de barras y puede contener mas información además del código identificador por ejemplos el nombre de la empresa que lo usa, tipo de producto, fecha de caducidad.
Desventajas:
  • Es una tecnología mas cara que el código de barras.
  • El precio del lector de código de barras.

RFID en dispositivos móviles

La tecnología RFID es relativamente nueva y por tanto no existen usos muy variados de estos en dispositivos móviles, algunas de las aplicaciones que encontré para dispositivos con sistema operativo android son:

NFC Doctor

[imagen obtenida de: https://lh4.ggpht.com/8wxz87exSeqfKqyZllKgXc7wXkaHDwgl21kbakntadz58rRL_-ZlzUOvvjUWfcScYD4=w124]
Es una simple aplicación para leer las etiquetas rfid(claro teniendo la tecnología necesaria en el dispositivo) con una interfaz gráfica amigable.

Portable RFID Reader via BT


[imagen obtenida de:https://lh5.ggpht.com/Nn_KyZxSo6w8Glf6vIUJbH_lhqfHQGIQlBF2_hmxHaKM0nwzGnZhSGRVweM5UeMkTXAX=w124]
Este es parecido al anterior utiliza el lector de el dispositivo para leer una etiqueta RFID y te muestra los datos de la misma.

Electronic Pickpocket RFID

[imagen obtenida de:https://lh4.ggpht.com/fNt2sG_m_rBvRtAtaHN6Ijy7tvM3iuqyuHbgpwpXhDogsfPtHqA7tcgaanJ56EPrKG8=w124]
Esta aplicación se usa en las nuevas tarjetas de credito con tecnología RFID para acceder a ellas y medir el nivel de seguridad en la misma, esto con el fin de evitar fraudes o robos.


Finder
Esta tecnología es relativamente nueva y de las pocas ideas que encontre para utilizarlo esta es la mas origina, los creadores de la idea son Chu Wang, Qiujin Kou, Qian Yin and Yonghua Zhang y se trata de un dispositivo que utiliza las etiquetas RFID instaladas en tus pertenencias, para llevar seguimiento de donde se encuentran tus pertenencias hasta ahora este producto es solo una idea pero esperemos que con el tiempo se pueda construir.

[imagen obtenida de:http://cdn.bitrebels.netdna-cdn.com/wp-content/uploads/2011/11/Finder-Item-And-Gadget-Locator-2.jpg]

Conclusiones

La tecnología RFID es una tecnología aun en desarrollo pero ha sido bastante esperada para identificación de productos. En lo personal me parece que tiene bastante futuro y me gustaría ver con el tiempo mas herramientas para trabajar con RFID y que los componentes necesarios sean mas baratos y en una amplia variedad.

Rererencias:
http://centros5.pntic.mec.es/ies.victoria.kent/Rincon-C/Curiosid2/rc-98/rc-98.htm
https://play.google.com/
http://www.bitrebels.com/technology/finder-rfid-locator-finds-your-misplaced-keys/

Manejando la pila de memoria en ensamblador


[imagen obtenida de:http://www.techfuels.com/attachments/ram/17492d1267249742-ram-computerram-main_full.jpg ]
 

¿Qué es la memoria principal?
La memoria principal o RAM (Random Access Memory) es una memoria en la que se puede acceder a cualquier parte de ella sin tener que acceder a partes precedentes de está. Está memoria es mas lentamente accesible que los registros pero mas rápida que el disco duro por eso es utilizada para guardar datos que se están utilizando en un determinado momento por un programa pero que no están siendo utilizados por operaciones comunes en los registros.

De forma lógica la memoria principal que normalmente es de entre uno a cuatro giga bytes es dividida en pequeñas celdas de 1 byte y cada celda se le da una dirección de memoria, después cuando un programa en ejecución necesita guardar datos se le asigna un rango de direcciones para trabajar.


[imagen obtenida de: http://www.jegsworks.com/lessons-sp/lesson4/memaddress.gif]

¿Que es la pila de memoria?
Una pila es una lista ordinal o estructura de datos en la que el modo de acceso a sus elementos es de tipo último en entrar, primero en salir que permite almacenar y recuperar datos.
En lenguaje ensamblador esta estructura de datos se utiliza para llevar control de los datos usados por diferentes bloques del programa y abstraer los bloques de ejecución en funciones y las variables(todo esto muy conocido en lenguajes de programación de capas superiores). Para esto retomaremos el tema de los registros, los registros utilizados por la pila de memoria son:

%ESP Stack Pointer

Este registro es un puntero(contiene la dirección de memoria de otra variable) hacia el ultimo elemento usado en la pila. Este se manipula de forma implícita por quien define el código.

%EBP Base Pointer

Este registro es un puntero que se utiliza para referenciar a los parámetros y variables locales de una función.

%EIP instruction pointer

Este guarda la dirección de la siguiente instrucción del CPU a ser ejecutada y se modifica directamente por las instrucciones "call"(mandar a llamar a una función) y "jmp"(saltar a otro bloque del código).

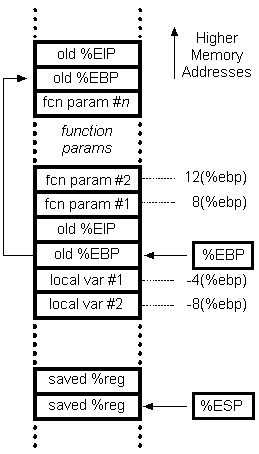
Ahora que sabemos para que sirve cada registro, necesitamos darnos una idea como se organiza la pila en ensamblador, cada que se entra a una función el puntero %EBP es el que marca donde empieza y termina, en cambio el puntero %ESP nos ayuda a saber donde terminan las variables locales de una función.


[imagen obtenida de: http://unixwiz.net/images/stackframe-cdecl.gif]

Es así que modificando el valor de estos registros punteros podemos manejar asignar fragmentos de memoria para diferentes fragmentos o funciones del programa por ejemplo para declarar una variable entera en Ansi C lo que se haría en assembly x86 seria:

 pushl  %ebp  ;Recupera la base de la pila de la función superior
 movl  %esp, %ebp ;Actualiza la el puntero %esp a la base de la pila anterior
 subl $4, %esp ;Despues le resta cuatro bytes a la dirección de memoria de %ebp
 movl $0,  (%esp) ;Ahora asigna el valor 0 al espacio que reservamos


PUSH
Esta es una operación que decrementa una cantidad de posiciones el puntero base(%EBP) y en la dirección resultante guarda los valores recibidos como operando.

POP
Esta operación sirve para recuperar el ultimo valor empujado con la operación push, esto quiere decir que recupera el valor superior al puntero %EBP y luego incrementa una cantidad de posiciones el puntero.


Ejemplo de recursión
Como ejemplo para manejo de pila decidi hacer el mismo que para la publicación anterior solo que esta vez lo construí utilizando un algoritmo recursivo, para mostrar el movimiento de punteros de pila llamando funciones recursivamente. 

.globl numeros
numeros:
 pushq  %rbp
 movq  %rsp, %rbp  
 jmp .LF                   ;Salta al ultimo bloque de la funcion
.L0:
 movq 16(%rsp),%rax    ;recupera el valor que se dio como parametro
 subq $1, %rax         ;y se le resta uno
 pushq %rax             ;Despues se empuja al puntero para mandarlo como parametro
 call  numeros          ;y se manda a llamar a su misma funcion
 popq %rax             ;recupera el valor parametro es igual a lo que hice cuatro
                             ; lineas anteriores pero ahora modificando el punteor base 
    pushq %rax             ;ahora manda el valor a la funcion print que yo mismo defini
 call  print            ;como en el ejemplo de la publicacion de registros
 popq %rax          
 
 movq 16(%rsp),%rax 
 addq $1, %rax
 movq %rax, 16(%rsp) ;suma uno al parametro recibido y termina la funcion

 leave
 ret
.LF:
 cmpl  $0,  16(%rsp) ;compara el ultimo valor mandado como parametro
 jg .L0                  ;si es mayor que cero pasa al bloque .L0 
    leave
 ret
 
.globl main

main:
 pushq %rbp  ;Recupera la base de la función anterior
 movq %rsp,  %rbp
 subq $8, %rsp 

 pushq $10      ;Mueve el valor 10 a la dirección del nuevo %RBP y disminuye el valor del puntero
 call numeros  ;Manda a llamar a la función numeros
 
 leave
 ret


Y esto fue el resultado que me imprimio en terminal:


Referencias:
http://www.masadelante.com/faqs/memoria-ram
http://www.jegsworks.com/lessons-sp/lesson4/lesson4-5.htm
http://es.wikipedia.org/wiki/Pila_%28inform%C3%A1tica%29
http://unixwiz.net/techtips/win32-callconv-asm.html
http://moisesrbb.tripod.com/unidad3.htm

miércoles, 9 de mayo de 2012

Manejando registros en ensamblador x86


[imagen obtenida de:http://www.elclarin.cl/web/images/stories/2012/marzo/hardware.jpg]

¿Qué es un registro?

En el hardware de las computadoras los registros son memorias que están cerca del procesador, los cuales son la memoria mas rápida de acceder por este, por tanto son muy valiosos para operaciones matemáticas y es muy común que operaciones en ensamblador reciban parámetros dentro de estos espacios de memoria.
Una de las desventajas de estos es que son bastante caros y esto hace que los registros dentro de nuestros ordenadores tengan una capacidad de almacenamiento bastante limitada.

En ensamblador podemos trabajar directamente con los valores de los registros, cosa que no pasa en lenguajes de capas superiores, utilizados de la manera correcta estos pueden ser una herramienta muy útil para generar programas potentes.

Principales registros ensamblador
Dentro de la familia de procesadores x86 existen 8 registros generales cada uno con características diferentes y usado para objetivos particulares, cada registro tiene una capacidad de 32 bits, pero en mis ejemplos quizás trabajaré con instrucciones de 64 bits puesto que la maquina a la que tengo acceso  tiene una arquitectura de 64 bits y el compilador "cc" me lo permite.

Los registros generales son los siguientes:
  • AX - Accumulator Register
  • BX - Base Register
  • CX - Counter Register
  • DX - Data Register
  • SI - Source Index
  • DI - Destination Index
  • BP - Base Pointer
  • SP - Stack Pointer

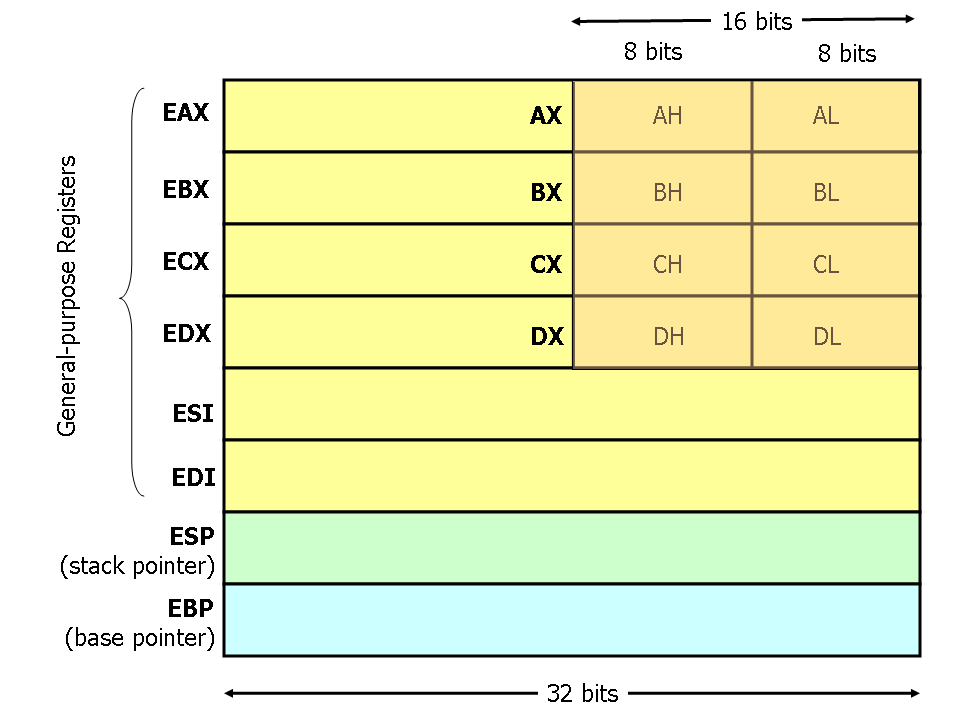
Se puede trabajar solamente con partes del registro por ejemplo AX representa una parte de 8 bits de tamaño de Accumulator Register, pero si quisieramos trabajar con los 32 bits del registro agregamos la letra "E" al inicio del nombre("EAX") y para registros de 64 bits se utilizaría la letra "R"("RAX")


[imagen obtenida de: http://www.cs.virginia.edu/~evans/cs216/guides/x86-registers.png]

Accumulator Register(EAX)

Este registro sirve para realizar operaciones como por ejemplo sumar o restar. En algunas arquitecturas este tipo de operaciones solo podría llevarse a cabo en un registro especifico para esto, pero en la arquitectura x86 se puede usar cualquier registro, pero es mas recomendable usar EAX puesto que este ya esta optimizado para ser utilizado de esta manera.

Counter Register(ECX)
Este registro es bastante obvio es un registro contador, normalmente se utiliza dentro de ciclos para saber cuando detenerse por lo tanto esto lo hace recomendable  para comparaciones.

Data Register(EDX)

Este registro esta íntimamente ligado con el registro "EAX" este se utiliza cuando los datos con los que trabajamos son muy grandes y no caben en "EAX" entonces la parte mas significativa de los bits del dato se guarda en "EAX" y los menos significativos en el registro "EAX"

Source Index(ESI)
Este se utiliza cuando se requiere trasladar datos de un bloque del programa a otro por ejemplo pasar datos de una función a otra.

Destination Index(EDI)

Este se utiliza cuando se requiere trasladar datos de un bloque del programa a otro por ejemplo asegurar datos en un ciclo para no tener que moverlos a la memoria principal. La diferencia con el registro ESI es que este es orientado a la escritura y el otro a la lectura.

Base Pointer(EBP) y Stack Pointer(ESP)
Este registro esta ligado a la pila de memoria de ensamblador, este registro y el registro "ESP" son la base para la utilización de funciones en el lenguaje ensamblador x86. Se usa para llevar control la abstracción a la cual se le llama función, la memoria principal se utiliza para llevar control sobre en que parte del programa se esta(función) y para saber que bloques de memoria serán utilizados por esta función. El registro "EBP" contiene un puntero al primer bloque de la memoria del rango de bloques para la función y "ESP" representa el ultimo bloque de memoria de una función.

Base Register(EBX)

Este registro es de uso general y no tiene ningún proposito en especifico.

Bloques de código ensamblador

Debido a que una computadora tiene normalmente una gran cantidad de procesos ejecutandose al mismo tiempo(por turnos) es necesario dividir nuestros programas en pequeños bloques de instrucciones dentro de las funciones para que los procesos que se ejecutan al mismo tiempo se turnen ejecutando sus bloques. Para dividir estos bloques se utilizan etiquetas con el siguiente formato ".nombre_de_la_etiqueta:" además estos bloques son utilizados para generar iteraciones en el lenguaje ensamblador.

A manera de ejemplo pongo el siguiente código donde se utilizan bloques de código y comparaciones para generar una iteración donde se imprimen los números del 0 al 9 utilizando un contador.

.globl main
main:
.LFB1: 
        pushq   %rbp  
        movq    %rsp, %rbp
        subq    $16, %rsp
        movl    $0, %ecx ; Mueve el valor incial cero ala variable que servira de contador
        jmp     .L3  ; De aqui salta al bloque de codigo .L3
.L4:
        movl    %ecx, %edi ;Mueve el valor de %ecx al registro %edi para mover el valor a la funcion que se va a ejecutar
        call    print  ;Esta funcion yo la defino recibe un numero entero y lo imprime con un formato especifico con la función printf
        addl    $1, %ecx ;Suma uno al valor del registro
.L3:
        cmpl    $9, %ecx ;Ahora compara el valor de %exc si es mayor que 9 (%ecx > 9)
        jle     .L4  ;En caso de que no se cumpla esa condición salta al bloque .L4

 leave
 ret


Al correrlo me genera la siguiente salida:


El programa no imprime los valores correctos en la terminal debido a que los registros son pocos y tienen una capacidad bastante pequeña, entonces de un bloque a otro, otro proceso podría modificar los valores dentro de los registros por tanto cuando se compara la primera vez tal vez haya conservado el valor 0 pero cuando vuelve a compararse pudo haber sido modificado por otro proceso por ejemplo la función printf puedo haberlo utilizado y haber puesto un valor mayor a 9 en el registro.
En estos casos resultaría útil utilizar la memoria principal para conservar los valores, pues dado que esta es mas grande se puede definir una cantidad de memoria a utilizar por el programa y de esta una mas para la función, lo cual hace los datos más fácilmente respetados por otros procesos. Entonces para corregir este código lo que hice fue:

.globl main
main:
        .LFB1:

                pushq   %rbp
                movq    %rsp, %rbp
                subq    $16, %rsp
                movl    $0, -4(%rbp)  ;Mueve el valor 0 a la memoría principal
                jmp     .L3
        .L4:
                movl    -4(%rbp), %edi ;Mueve el valor principal al registro %edi
                call    print
                movl    -4(%rbp), %eax ;Recupera el valor de la memoria
                addl    $1, %eax        ;Suma 1 al valor de %eax
                movl    %eax, -4(%rbp) ;Devuelve el valor a la memoria principal
        .L3:
                movl    -4(%rbp), %ecx ;Recupera el contador de la memoria principal
                cmpl    $9, %ecx       ;Compara si es menor que 9 valor en el registro
                jle     .L4            ;Salta al bloque .L4 si la condición no se cumplio

              leave
         ret


Y el resultado es el siguiente:


Con esto podemos comprobar que a pesar de que los registros son de muy rápido acceso, son muy limitantes en el sentido de que son escasos y tienen que se repartidos entre procesos en el sistema. A pesar de ello los registros son esenciales en las arquitecturas de computadoras y mezclados con otros medios de almacenamiento y los algoritmos correctos esto los hace muy necesarios y útiles.

Referencias
http://www.swansontec.com/sregisters.html
http://www.cs.virginia.edu/~evans/cs216/guides/x86.html

¿Por que debo aprender ensamblador?


El lenguaje ensamblador es el lenguaje de programación mas básico para cualquier procesador como sabemos un sistema de arquitectura de computadoras comunmente se divide en cinco capaz las cuales son: hardware, firmware, ensamblador, kernel, sistema operativo y aplicaciones. La capa de ensamblador comúnmente define un grupo de instrucciones relativamente fácil de entender por el ser humano estándar para un grupo de procesadores. Este lenguaje casi no contiene instrucciones abstractas lógicas lo que hace es trabajar directamente con operaciones del CPU y estas instrucciones de forma mas directa con los componentes de las computadoras. Otra característica del lenguaje ensamblador es que es bastante poderoso pues no tiene las limitaciones que vienen con lenguajes de programación de capaz superiores aunque resulta mas tedioso trabajar con este.


Breve repaso historico

En la década del 40, surgen representaciones para estas instrucciones. Ya no eran unos y ceros, sino que se los representaba con palabras más fáciles de recordar (instrucciones mnemónicas) como MOVE, LDA, ADD, etc.

La relación con el código binario era directa, por cada instrucción MNEMONICA, existe una instrucción en binario y viceversa. Así se construyen los primeros traductores que pasarán la instrucción MNEMONICA a Binario. Estos traductores recibieron el nombre de ensambladores, y se convirtieron en el primer lenguaje de los ordenadores. De todas maneras, la programación era complicada y difícil, porque se acercaba mucho a la forma de operar de las computadoras y no al lenguaje humano (llamados lenguajes de programación de alto nivel).


¿Por que usar ensamblador?
En primer lugar ¿Por que debería yo estar aprendiendo un lenguaje relativamente complicado si hoy en día existen lenguajes que con menor esfuerzo producen operaciones mucho mas complejas?


Para entender esto lo que hice fue empezar a pensar como funcionaba una arquitectura desde las capas mas bajas, a grandes rasgos junta varias operaciones de su cerebro(CPU) para procesar números guardados en sus registros o memorias, para operaciones mas complicadas necesita juntar un mayor número de instrucciones o repetir muchas veces una misma, esto para ahorrar recursos al fabricar una maquina.
Por ejemplo si se necesitara un procesador cuya única operación fuera sumar un número "A" a un número "B" se podría construir el procesador para que sepa hacer eso, otra forma sería si tuvieramos una operación mas sencilla que sume uno a un valor "A" que recibe y este proceso lo repetimos "B" veces obtendremos los mismos resultados, de forma mas lenta pero ahorrariamos puertos de entrada para el procesador y además sería mas fácil de construir.

De la misma forma en capas superiores se juntan un grupo de operaciones que hacen mas fácil implementar las instrucciones para la maquina, pero que no siempre son las mas óptimas.

Ejemplo

Ahora para ejemplificar esto y entender mejor las características de este y por que es tan importante que un desarrollador de software entienda las mismas utilizare el lenguaje ensamblador versión x86, debido a que paso gran tiempo trabajando en linux y Ubuntu ya trae un compilador de ensamblador x86 a código maquina y también para convertirlo a código ensamblador.

Este es un código en Ansi C que parece bastante sencillo, todo lo que hace es guardar dos valores "a" y "b" en la memoria despues los divide e imprime los resultados en la terminal:

#include                                     
                                                                                
int main(int argv, char** argc){                                                
  int a = 5, b = 4;                                                             
                                                                                
  printf("%d",(a/b));                                                           
  return 0;                                                                     
}


Una vez que construí este código utilice el compilador "gcc" el cual ya viene por defecto en ubuntu para generar código ensamblador, lo cual lo hice agregando el parámetro "-S" y la dirección del archivo:

gcc -S ejemplo01.c

Lo cual me genero el archivo ejemplo01.s con el código en ensamblador x86. Para compilarlo en un ejecutable utilice el comando "cc"

cc ejemplo01.s


Que me generó un ejecutable con el nombre a.out. El código generado es el siguiente(quitando algunas lineas de encabezado y cosas innecesarias y agregando comentarios):

.LC0:
 .string "%d"
 .text
.globl main

main:
.LFB0:
 pushq %rbp  ;Busca la cima de la pila para manejar la memoria principal(RAM)
 movq %rsp, %rbp ;Mueve la posicion de la cima de la pila a otro registro

 subq $32, %rsp       ;Reduce la dirección de la posición para asignar los valores a trabajr
 movl %edi, -20(%rbp) ;Recibe valores pararametro y los pone en la memoria principal
 movq %rsi, -32(%rbp) ;
 movl $10, -4(%rbp)   ;Mueve el valor 10 a una posición en la memoria principal
 movl $2, -8(%rbp)    ;hace lo mismo con el siguiente valor 
 movl -4(%rbp), %eax  ;Mueve el valor 10 de la memoria principal a un registro  
 movl %eax, %edx      ;Ahora mueve el valor 10 a un registro diferente
 sarl $31, %edx       ;Mueve algunos bits menos significativos
 idivl -8(%rbp)       ;Divide el valor 10 entre el valor que esta en la memoria principal en este caso 2
 movl %eax, %esi      ;La funcion anterior pone el resultado de la division en el registro %eax luego este 
                      ; Se mueve a el registro %esi para mandarlo como parametro a la funcion printf de C
 movl $.LC0, %edi     ;Otro parametro a la funcion en este caso un puntero hacia el string que imprimira en pantalla
 movl $0, %eax        ;Otro parametro para definir cantidad de parametros
 call printf          ;Manda a llamar a la funcion printf y en este momento se escribe el valor de la division en pantalla
 movl $0, %eax ;
 leave                ;Pierde el control del programa
 ret                  ;Regresa a la funcion donde fue llamado si no es el caso termina la ejecucion del programa


Como podemos observar la cantidad de instrucciones que tenemos que definir es mayor que en Ansi c esto puede ser una ventaja o una desventaja. La desventaja de esto es obvia aumenta la complejidad para generar código útil. La ventaja esta en que nos deja definir caracteristicas que en otros niveles computacionales el los lenguajes nos esconden por ejemplo el manejo directo de la memoria y o la capacidad de utilizar los registros como queramos los cuales son mas faciles y rapidos de acceder por el procesador.

Al pasar el lenguaje de código Ansi C el cual es mas facíl de construir no genera un código completamente ótimo para utilizarse por ejemplo en este caso mueve distintos valores a la memoria principal cuando podría haber movido uno solo y el otro solamente definirlo como parametro en la división ahorrandonos una posición en la memoria principal. Esto nos da la ídea de que los lenguajes de programación no tienen los algoritmos para traducir un lenguaje a otro nivel (Si es que existe uno) desperdiciando recursos que en algúnas ocaciones pueden ser bastante valiosos(otra ventaja de ensamblador).

Tomando en cuenta que en sistemas integrados trabajare con microcontroladores con una capacidad de almacenamiento y procesamiento muy limitada esta es una  de esas ramas en las que nos es muy conveniente conocer las caracteristicas del lenguaje ensamblador.


Referencias:

jueves, 19 de abril de 2012

Tarea 4: Modelos caoticos


Buen día.

Esta semana tocamos el tema de los sistemas caóticos. Estos sistemas son muy importantes por que se encuentran en todos lados, por ejemplo en el ritmo del latido del corazón, en la dinámica de crecimiento poblacional, en el flujo de movimiento del agua de un río, etc.

La principal característica de estos sistemas caóticos es que estos tienen un alto grado de sensibilidad a las condiciones iniciales, por lo que si se intenta modelar y predecir, un pequeño cambio en las variables iniciales o las condiciones, hacen que los resultados cambien significativamente, un ejemplo de esto es el valor del dolar respecto al euro. Donde como se puede ver en la siguiente gráfica resultaria dificil modelar una función para tratar de estimar a largo plazo cual sería su valor.

[imagen obtenida de: http://news.bbc.co.uk/media/images/38137000/gif/_38137123_eurodollar2_300graph.gif]

Definición del caos de Devaney(1986):

Según este personaje el caos tiene tres componentes:

Transitividad

Dadas dos zonas cualesquiera del espacio donde esta definida
la función, existe un punto en la primera zona cuya órbita visita, en algún
momento, la segunda.

Dependencia sensible a las condiciones iniciales

Supongamos que x0 es un punto fijo un intervalo. Si para puntos cercanos
a x0 observamos que sus órbitas se mantienen , para toda iteración del intervalo,
cercanas a x0, entonces diremos que x0 es un punto fijo estable. Digamos que
nuestra idea de estabilidad en un punto fijo se refiere a que el comportamiento
de todas las órbitas que inician cerca de él se comportan casi como órbitas
de puntos fijos.

Densidad en el conjunto de puntos periódicos

Lo cuál quiere decir que cada punto en un intervalo de números reales existe en un conjunto de números periódicos (Puntos que vuelven a aparecer después de cierta iteración).


Automatas ceulares


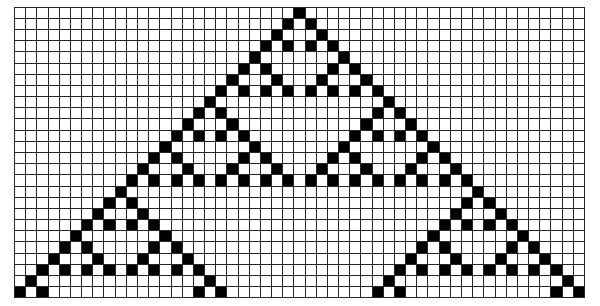
Un modelo automata celular es un modelo que se representa una malla de células donde cada celula en un tiempo discreto finito puede tener un valor de 1 o 0. La función de su siguiente estado, depende directamente de la cantidad de vecinos y su valor.


[imagen obtenida de: http://atlas.wolfram.com/01/01/18/01_01_162_18.gif]


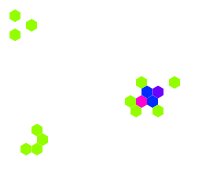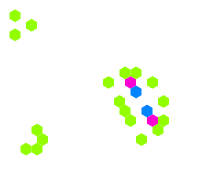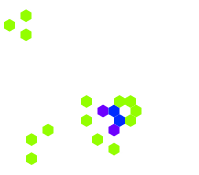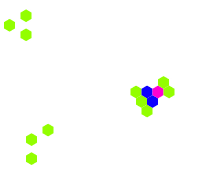
Los autómatas celulares pueden ser de cualquier dimensión y no necesariamente tienen que se representados con cubos o tablas, podrían representarse con cualquier grafo y los autómatas pueden ser fácilmente utilizados para simular un sistema.


[imagenes obtenidas de: https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEgHxlYU92r3RjKD1yrGUQM7YfQEbc2ayIaMupQnzVNxNl08KxAv_0GfDkBo5X3-WNsjCbEb2YO-ZWuIBU-4lmcsGYsAfU7WHu1XpuExnttCqRDgiTlH65vQlo51VLPzBnPe1YtcsP36qJyY/s400/ca_sur_06.jpg y http://upload.wikimedia.org/wikipedia/commons/8/86/Oscillator.gif]


El juego de la vida de Conway

El juego de la vida es un automata ceulular creado en 1970 por el matematico britanico John Horton Conway.  Este juego es de cero personas esto quiere decir que para interactuar con el se crean configuraciones iniciales y se obserban como avanzan en tiempos discretos.


Reglas del juego
El juego representa seres vivos que interactuan entre si, se representa por medio de una malla cuadrada de dos dimensiones, y cada celula puede tener dos estados, vivo o muerto. El sistema avanza en estados discretos y el estado siguiente de cada celula depende de la cantidad de vecinos en un estado anterior.
Las reglas del juego son las siguientes.
  1. Cada célula viva con menos de dos vecinos vivos, muere por desolación.
  2. Cada célula viva con dos o tres vecinos vivos sobrevive al siguiente estado.
  3. Cada célula viva con mas de tres vecinos vivos muere por sobrepoblación.
  4. Cada célula muerta con exactos tres vecinos vivos se convierte en una célula viva, por que se reproducen.
Para argumentar por que esté sistema se considera un modelo caótico, programé el juego usando Javascript y HTML5. El código es el siguiente:

function calcular_vecinos(filas, columnas, i, j, matrix, vecinos){
    vecinos[i][j] = 0;
    for( var i2 = i-1; i2<=i+1; i2++){
    	for( var j2 = j-1; j2<=j+1; j2++){
	    if( (i2>=0) && (j2>=0)  && (i2		if( ( matrix[i2][j2] == 1 ) && ( (i2 != i) || (j2 != j) ) )
		    vecinos[i][j] = vecinos[i][j]+1;
	    }
	}
    }


    return vecinos;
}

function siguiente_estado(filas, columnas, matrix, vecinos){
    for( var i = 0; i< filas; i++){
    	for( var j = 0; j< columnas; j++){
			vecinos = calcular_vecinos( filas, columnas, i, j, matrix,vecinos);
        }
    }

    for( i = 0; i < filas; i++){
    	for( j = 0; j < columnas; j++){
			if( matrix[i][j] == 1 ){
				if((vecinos[i][j] < 2) || (vecinos[i][j] > 3) )
                                    matrix[i][j] = 0;
			}else{
				if(vecinos[i][j] == 3) 
                                    matrix[i][j] = 1;
			}
		}
	}
    return matrix;
}

function dibujar(){
    for( var i=0; i        for( var j=0; j            if( matrix[i][j] == 1){
                context.fillRect( (i*pixel)+0.5, (j*pixel)+1.5, pixel, pixel);
            }
        }
    }
}


function clickListener(e) {
    if(activo == 0){
        espera();
	activo = 1;
    }else{
        activo = 0;
    }
}

var filas = 200;
var columnas = 100;
var matrix = Array(filas);
var vecinos = Array(filas);
var pixel = 2;

for(var i=0; i    matrix[i]=Array(columnas);
    vecinos[i] = Array(columnas);
    for( var j=0; j        matrix[i][j]=0;
        vecinos[i][j]=0;
    }
}

for( i=0; i    for( j=0; j        if(Math.random()<0.40)
            matrix[i][j]=1;
    }
}

canvasElement = document.createElement("canvas");
canvasElement.id = "cosa";
document.body.appendChild(canvasElement);
var canvas = document.getElementById("cosa");
canvas.width = 1+(filas*pixel);
canvas.height = 1+(columnas*pixel);
var context = canvas.getContext("2d");

context.fillStyle = '#F0DB4F';
context.fillRect(0,0, canvas.width,canvas.height);
context.lineWidth = 3;
context.strokeStyle = 'black';

canvas.addEventListener("click", clickListener, false);
var activo = 0;

function espera(){
    canvas.width = 1+(filas*pixel);
    canvas.height = 1+(columnas*pixel);
    dibujar(matrix, pixel);
    if( activo == 1)
        matrix = siguiente_estado(filas, columnas, matrix, vecinos);
    setTimeout("espera()", 400)
}


-
Ahora como ya sabemos un modelo caotico es muy sencible a un cambio en las condiciones iniciales (en este caso la configuración inicial) Para demostrar que el sistema elegí una plantilla del juego de la vida llamada "beacon" despues para comparar sus secuencias coloque una copia exacta de esta y agregue un pixel de mas, y en este link se muestra( dar click al cuadro amarillo para empezar la simulación y otro click para detenerla):
http://www.maxkalavera.iblogger.org/sensibilidad.html


Como podemos ver las secuencias cambian de forma drastica por un lado una configuración permanece ciclica cambiando cada estado, en cambio la otra imagen permanece inmóvil.

Por ultimo utilice valores aleatorios para generar una configuración inicial y el resultado son grupos de células con caracteristicas en sus secuencias diferentes para cada una, algúnas se repiten, otras cambian constantemente y otras solamente quedan inmóviles hasta que otro grupo interactué con ellas haciendo dificil predecir su comportamiento en un futuro relativamente lejano, muy similiar a lo que sucede en poblaciones de personas ( dar click al cuadro amarillo para empezar la simulación y otro click para detenerla).
http://www.maxkalavera.iblogger.org/conway_game_of_life.html


 Referencias:
 http://www.clausewitz.com/Complex/ChaosDemos.htm 
http://www.dynamics.unam.edu/NotasVarias/intro-sistemas.pdf http://books.google.com.mx/books?id=Hjua2EpKkKQC&pg=PA99&lpg=PA99&dq=simulation+heat+chaos&source=bl&ots=HMhTRO0aMt&sig=tivXw1cA90IDB8bhcIPRAedAxsI&hl=es&sa=X&ei=8fqRT9HOHqbC2wWGpdDoBA&ved=0CCkQ6AEwAQ#v=onepage&q=simulation%20heat%20chaos&f=false http://en.wikipedia.org/wiki/Conway%27s_Game_of_Life
 http://en.wikipedia.org/wiki/Cellular_automaton

martes, 17 de abril de 2012

Tarea de ensamblador - Cálculo de combinaciones

------------------------------
.LC0:
 .string "%i\n"

 .globl print
print:
 pushq %rbp
 movq  %rsp,  %rbp

 movq 16(%rsp), %rsi ;Mueve el valor de la memoria principal al registro %rsi
 movq $.LC0,   %rdi ;Mueve el puntero de el string al registro %rdi
 movl $0,   %eax ;Valor parametro para afirmar a printf que hay un solo valor parmetro
 call printf       ;Llama a la funcion printf

 leave
 ret


 .globl factorial
factorial:
 pushq %rbp
 movq  %rsp,   %rbp

 jmp .LF
.Factorial0:
 movq 16(%rsp), %rax ;Recupera el valor de la cima de la pila
 subq $1,  %rax ;Le resta uno al valor en %rax
 pushq %rax       ;Mueve el valor a la cima de la pila
 call  factorial      ;Llama a factorial
 popq %rax       ;Recupera el valor regresado por esta funcion

 movq 16(%rsp), %rdx 
 imulq %rax,  %rdx ;Este valor lo multiplica por el valor que recibio como parametro
 movq %rdx,  16(%rsp) ;Regresa el valor de la multiplicacion

 leave
 ret
.Factorial1:
 movq $1,  16(%rsp) ;Regresa el valor 1
 leave
 ret
.LF:
 cmpl  $1,   16(%rsp) ;Compara el valor en la memoria principal con 1
 jg .Factorial0   ;Si el valor es mayor que 1 pasa al bloque indicado

 cmpl $0,  16(%rsp) ;Si el valor es igual a 0 pasa al bloque indicado 
 je .Factorial1
 leave
 ret

.globl combinaciones
combinaciones:
 pushq %rbp  
 movq %rsp,  %rbp
 subq $24, %rsp

.L1:
 pushq 48(%rsp) ;Manda el segundo parametro recibido, como parametro para factorial
 call  factorial
 popq (%rsp)  ;Mueve el resultado a los primeros 8 bytes resevados
 
.L2:
 pushq 40(%rsp) ;Manda el primer parametro recibido, como parametro para factorial
 call factorial
 popq 8(%rsp)  ;Mueve el resultado a los siguientes 8 bytes resevados
.L3:
 movq 48(%rsp),  %rax
 movq 40(%rsp), %rdx ;Recupera los valores recibidos como parametros
 subq %rdx,  %rax ;Resta el primer parametro al segundo
 pushq %rax       ;Lo empuja a la cima de la pila
 call factorial      ;Obtiene su factorial
 popq 16(%rsp)      ;Lo recupera
.L4:
 movq 8(%rsp), %rax
 movq 16(%rsp), %rdx
 imulq %rax,  %rdx ;Multiplica los divisores

 movq (%rsp),  %rax
 movq %rdx,  %rbx
 movq $0,  %rdx
 idivq %rbx  ;Divide el factorial del primer parametro entre el divisor
 movq %rax,  48(%rsp) ;Pone el resultado en el primer parametro empujado a esta funcion

 leave
 ret

 
.globl main
 
main:
 pushq %rbp  ;Empuja el registro a la cima de la pila
 movq %rsp,  %rbp ;Mueve el registro %rsp a la cima de la funcion
 subq $32, %rsp ;Resta 32 al valor del registro %rsp
.M1:
 movq %rsi, %rax ;Mueve el valor puntero de %rsi a %rax
 movq %rax, (%rsp) 
 addq $8, %rax ;Mueve el puntero dos bytes arriba del stack
 movq (%rax), %rdi ;Esta vez mueve el valor en la memoria principal a el registro %rdi
 call  atoi  ;Manda a llamar al funcion atoi para convertir el valor en %rdi a entero 
 movq %rax, 16(%rsp) ;Recupera el valor regresado por atoi y lo mueve a la memoria principal
 
.M2:
 movq (%rsp), %rax ; recupera y convierte a entero el siguiente valor 
 addq $16, %rax 
 movq (%rax), %rdi 
 call  atoi  
 movq %rax, 24(%rsp)
.M3:
 movq 16(%rsp), %rax
 movq 24(%rsp), %rdx 
 pushq %rax  ;Empuja los parametros a la cima de la pila
 pushq %rdx  
 call combinaciones  ;Llama a la funcion de combinaciones
 
.M4:
 popq %rax  ;Recupera el valor que produce la funcion y luego lo manda a imprimir
 call print
 
 leave
 ret
 

jueves, 29 de marzo de 2012

Tarea 3: Pruebas estadísticas para los números pseudoaleatorios


Las aplicaciones de los números aleatorios en la actualidad se ha vuelto tan diversa y tan importante en la actualidad que se necesita de cierto grado de calidad para que sea utilizable para las personas. Por eso esta semana quiero hablar sobre los generadores de números aleatorios y algunas pruebas para tener una mayor seguridad de que los generadores que utilizamos tienen la calidad ya mencionada.

Las aplicaciones de los números aleatorios son :

  • Criptografía.
  • Simulaciones.
  • Videojuegos.
  • Muestras en experimentos.
  • Obras de arte.

Generadores de numeros aleatorios

Los generadores de números aleatorios es un algoritmo determinista que producen una variable al azar especificada por una distribución..

Pruebas de aleatoriedad

PPara las pruebas de aleatoriedad elegí tres pruebas como ejemplo del conjunto de pruebas de NSIT los cuales son:

  • Frequency Test - Monobit: El propósito de esta prueba es determinar si la proporción de ceros y unos obtenidos.
  • Frequency Test - Block: El propósito de esta prueba es determinar la proporción de unos en bloques de M-bits (M=cantidad de bits por bloque)
  • Runs Test: El propósito de este es medir la cantidad de secuencias de bits idénticos interrumpidos.


import math
import random
from scipy.stats import chi2 

def frecuency_monobit(n ):
   sn = 0
   for i in range(n):
       bit = random.randint(0, 1) # numeros aleatorios 0 y 1
       if bit == 1:
           sn = sn + 1
       else:
           sn = sn - 1
   sobs = math.fabs(sn)/math.sqrt(n) 
   p_value = math.erfc(sobs/math.sqrt(2))
   
   return p_value

# M-> logitud de cada bloque
# n-> numero total de muestras
# N-> numero de bloques
def frecuency_block(n, M):
    N = int( n / M)
    bloques = []
    for i in range(N):
        bloques.append(0.0)
        for j in range(M):
            bit = random.randint(0, 1)
            if bit == 1:
                bloques[i] = bloques[i] + 1.0
        bloques[i] = bloques[i] / M

    x2obs = 0
    for i in bloques:
        x2obs = x2obs + (i-0.5)**2
    x2obs = 4*M*x2obs
    return (1.0 - chi2.cdf(x2obs, M-1))

#numero de muestras
#verificar el contador de cambios
def run_test(n):
    media = 0.0     vn_ops = 1.0

    for i in range(n):
        nuevo = random.randint(0,1) #int(algo[i])
        media = media + nuevo
        if i > 0 and anterior != nuevo:
            vn_ops = vn_ops + 1
        anterior = nuevo
    media = media / n

    if math.fabs(media-0.5) <= (2 / math.sqrt(n)):
        return math.erfc( math.fabs(vn_ops - 2*n*media*(1-media) )  / ( 2*math.sqrt(2*n)*media*(1-media) )  )
    else:
        return "run_test(): Prueba rechazada"

print frecuency_monobit(1000)
print frecuency_block(100,10)
print run_test(100) 
Estas pruebas generan un numero el cuales la regla de decisión es que si los valores son menores a 0.01 entonces se considera que la muestra es aleatoria.

Para revisar esto genere 10 veces cada prueba y como se puede observar, la mayoría de estas pasan la prueba lo cuál nos entrega un poco mas de seguridad de el generador.


Generador de numeros Poisson

Una vez que tengo una cierta seguridad de que los números que son el producto de el generador tienen las características necesarias para considerarse les aleatorios, ahora puedo intentar generar números con una distribución para mis fines de simulación, en mi caso practique haciendo un ejemplo convirtiendo los números producto del generador de python a la distribución poisson.

import math
import random

def poisson(lamb):
    acumulador = exponencial( lamb)
#    acumulador = 0
    contador = 0
    while( acumulador < 1):
        acumulador = acumulador + exponencial( lamb)
        contador+=1
    return contador


def exponencial(lamb):
    return (-1*math.log( random.random() ))/lamb

def buscar(vector, buscado):
  for i in range(len(vector)):
      if vector[i][0] == buscado:
          return i
  return -1

def contar(fl, n, lamb):
    numeros = []
    for i in range(n):
         generado = poisson(lamb)
         pos = buscar(numeros ,generado )
         if pos != -1:
             numeros[pos][1] += 1
         else:
             numeros.append([generado ,0 ])
    try:
        fl = open(fl , "w")
    except:
        print "Error al arbir el archivo"

    for i in numeros:
        i[1]=float(i[1])/n
        fl.write(str(i[0])+" "+format(i[1], '.6f')+"\n")

    try:
        fl.close()
    except:
        print "Error al cerrar el archivo"

contar( "poisson.dat", 1000000, 20)
poisson_esperado("esperado.dat", 1, 50, 20)
-----------------------------
Este fue mi primer resultado, para comparar los números que esperaría que salieran con los números obtenidos genere 1000000 números con mi generador de números pPoisson y después conté el número de ocurrencias de cada uno y estas dividirlas entre el total para obtener una probabilidad práctica de que genere ese número mi programa. Después lo gráfique junto con la formula de la distribución Poisson dándole como parámetro una lambda semejante y el resultado fue el siguiente:


Después de algunas pruebas y modificaciones el resultado fue el siguiente donde los números tienen una probabilidad práctica muy parecida a la de la formula de Poisson, con lo cuál compruebo que este generador tiene cierta calidad para usarla en futuras simulaciones.


Referencias:
http://es.wikipedia.org/wiki/Generador_de_n%C3%BAmeros_aleatorios
Página de NIST- http://csrc.nist.gov/groups/ST/toolkit/rng/index.html

Presentación del proyecto medio curso


Es un juego entre dos personas, cada una con 16 piezas, en un tablero de 8x8. Cada pieza tiene características especiales para moverse y atacar otras piezas y el objetivo es derrocar al rey enemigo.
El objetivo es llevarlo a una dispositivo móvil que utilice el sistema operativo Android usando la pantalla táctil y la cámara como interfaces de entrada y salida con el usuario. Además de agregar características de realidad aumentada.

Importancia/impacto esperado del proyecto

La importancia del proyecto se encuentra en que tratar de juntar las mejores características de los juegos de ajedrez ya existentes y tratar de añadir características que no existen en los juegos ya existentes como es la realidad aumentada

La realidad aumentada (RA) es el término que se usa para definir una visión directa o indirecta de un entorno físico del mundo real, cuyos elementos se combinan con elementos virtuales para la creación de una realidad mixta en tiempo real. Aquí muestro un vídeo de el proyecto de Jaimie Thom quien trabaja con algo parecido pero usando una computadora de escritorio.


Esta es la pagina del proyecto y aquí se puede encontrar mas información del mismo: http://jaimie2819.posterous.com/augmented-reality-chess-game-final-documentat

El plan es dar la ilusión de tener un tablero real frente al usuario(para esto usar la cámara) y que la interacción con el tablero sea lo mas real posible, ya seleccionando una pieza usando la pantalla táctil o pasando la mano sobre ella para seleccionar.


Herramientas y tecnologías utilizadas:


  • El SDK de Android: Me servirá para compilar y probar mis aplicaciones.
  • Eclipse: Como IDE para desarrollo se integra con el SDK de Android por lo cual me resultara útil.
  • QCAR: Librería de realidad aumentada desarrollado por la empresa Qualcomm. Es gratuito, gratuito y parece tener una buena documentación.
  • Cacoo: Herramienta para generar gran cantidad de diagramas y diferentes tipos de diseños de interfaces gráficas.
  • GanttProject: GanttProject es una herramienta de escritorio multiplataforma para la calendarización y gestión de proyectos.

Diagrama de Gantt


Como se puede ver las partes mas significativas de el proyecto son tener la lógica del juego, después pasarlo a android con las características necesarias para que el sistema funcione correctamente en un dispositivo móvil tomando en cuenta las restricciones de este.
Después se añade la parte de la realidad aumentada, con la estructura del sistema tenemos hábil abstraer entradas y salidas del programa para poder añadir por módulos este tipo de características puesto que aun no estoy completamente seguro como funcione la librería que escogí.
Una vez hecho esto corrijo lo que haya que corregir y me centro en los detalles y pruebas con esto se da el proyecto por finalizado.

Saludos

Links útiles:

lunes, 12 de marzo de 2012

Tarea 2: Procesos estocásticos discretos y continuos

Buen día.

Problema a analizar:

Dos jugadores de poker empiezan una partida amistosa, Alice y David. Alice reparte las cartas y se da cuenta que su mano muy buena( póker) y entre sus cartas un 9 de treboles. Por otro lado David recibe una mano bastante peculiar, un Rey, una Quina, un Joto todos de treboles y un 2 de diamantes. Como puede observarse es una mano muy buena pero necesita un As de treboles y para vencer a Alice. Despreciando la idea de que Alice tambien puede pedir cartasy el final del juego. ¿Cuál es la probabilidad de que david saque un As de treboles del mazo?, ¿Cuál es la probabilidad de que lo haga en el siguiente turno si la carta obtenida anteriormente se introduce de nuevo en el mazo y se barajea el mismo? y ¿Cúal es la probabilidad de que lo haga en el siguiente intento?.


Para responder las preguntas anteriores ponemos darnos cuenta que el problema tiene las caracteristicas de uns distribución geometrica, pero pimero:

¿Qué es una distribución de probabilidad?
Una función que asigna a cada suceso definido sobre la variable aleatoria la probabilidad de que dicho suceso ocurra. El rango de esta función constituye todos los sucesos que puedan ocurrir en el conjunto o en la situación analizada.

Los tipos de distribuciones son los siguientes:


Distribuciones discretas:
Se consideran distribuciones discretas las cuáles su función solo puede tomar valores positivos, finitos o finitos númerables.

Entre las mas comunes se encuentran:
  • Distribución de Bernoulli: Donde se mide la probabilidad de exito a fracaso de un suceso.
  • Distribución binomial: Donde se mide la probabilidad de exito o fracaso en sequencia una cantidad determinada de veces.
  • Distribución binomial negativa: Donde se mide la probabilidad de que en un número determinado de intentos obtener otra cantidad determinada de exitos.
  • Distribución Poisson: Donde se mide la probabilidad de que un numero de eventos ocurran en tiempos especificos.
  • Distribución geométrica
  • Distribución hipergeométrica

Distribuciones continuas:
Se consideran distribuciones continuas las cuáles su función puede tomar valores infinitos dentro de un intervalo definido.

Entre las mas comunes se encuentran:
  • Distribución exponencial
  • Distribución normal
  • Distribución uniforme (continua)
  • Distribución F


Distribución geométrica
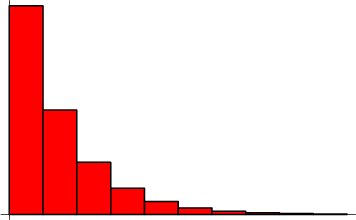
[imagen obtenida de: http://mathworld.wolfram.com/images/eps-gif/GeometricDistribution_800.gif]


Esta distribución analiza el numero de ensayos de Bernoulli que se necesitan para llegar al primero éxito. Su rango va desde uno hasta el infinito, puesto que por lógica debe haber al menos un intento y los intentos pueden ser ilimitados. Como los intentos pueden ser ilimitados, se puede verificar que si se suman los valores de la función de uno al infinito esta suma tiene como resultado uno.

Su formula de probabilidad es la siguiente:

Para x=1,2,3...

Donde "p" es la probabilidad de éxito y "q" que es "q=(1-p)" la probabilidad de fracaso, como uno es la probabilidad total a esta se le resta la probabilidad de éxito y lógicamente esta probabilidad que queda es la de fracaso.

La formula del valor esperado es :


Ahora volviendo al problema de la partida de póker

para analizar el problema primero obtendremos la probabilidad de que en un ensayo de Bernoulli haya un éxito o un fracaso, primero definimos el éxito: Un mazo de cartas tiene 52 cartas pero diez de estas ya están en manos de los contrincantes por lo tanto no las tomaremos en cuenta, eso nos deja 42 cartas de las cuales solo nos es útil entonces la probabilidad de acierto es 1/42.

Entonces "p = 1/42" lo cuál hace que :
q = (1-(1/42)) = 42/42 - 1/42 = 41/42
Sustituyendo esto en la formula:
P(x) = ((41/42)^0)*(1/42) = 1/42


Puesto que en el primer intento la probabilidad de éxito es la misma que un solo ensayo de Bernoulli o intentar una ves. Para ver el comportamiento de la probabilidad de que el primer éxito sea en un numero de intento mayor.

Ahora para responder las otras dos preguntas realice una gráfica con un programa que hicimos en la clase. El eje horizontal es el número de veces que se debe lanzar la moneda y el eje vertical es la probabilidad.


Como es observable es entre mas aumenta la cantidad de intentos mas improbable se vuelve que esa sea la del primer éxito.

versión continua - distribución exponencial

La distribución exponencial es la distribución que mide la probabilidad de que de dos eventos específicos y que ocurren regularmente sucedan uno de tras de otro con una diferencia de tiempo especifica = "x".

Los parámetros de la función son el tiempo "x" y la frecuencia con la que  ocurre el evento en una unidad de tiempo que se representa con la letra griega lambda( λ).

La función de la densidad de la probabilidad es:
La formula para obtener el valor esperado es la siguiente:

Una de las cosas que caracterizan esta distribución es que se dice que esta no tiene memoria. Esto quiere decir que

una vez esperados un tiempo "T" antes de un evento esto no quiere decir que el tiempo de espera para el siguiente evento vaya a disminuir, este sigue teniendo la misma distribución de probabilidad.

Para entender esta función modifique un programa que hicimos en clase para graficar esta el cuál es el siguiente:

function exponential(lambda, filename)
  output = fopen(filename, "w");
  prob = 1;
  x = 1;
  while (prob > 0.0)
    prob = 1-exp(  ((-1*lambda)*x) );
    x++;
    fprintf(output, "%d %f\n", x, prob);
  endwhile
  fclose(output);
endfunction

Y gráfique el siguiente ejemplo digamos que cada jugada en el juego entre David y Alice dura dos en promedio dos minutos entonces si nuestra unidad de tiempo son los minutos entonces se podria decir que se le entrega a David media carta por minuto osea que " λ = 0.5" así que para analizar esto hize la siguiente gráfica donde el eje vertical es la probabilidad y el horizontal el tiempo:


Como  puede observarse al avanzar el tiempo la gráfica tiende a acercarse a uno lo cuál nos dice que  entre más tiempo pase mas probable es que se lleve a cabo la siguiente partida.

referencias:
http://es.wikipedia.org/wiki/P%C3%B3quer
http://es.wikipedia.org/wiki/Distribuci%C3%B3n_de_probabilidad